LangChain实战
langchain项目实战
本地环境搭建
详见文章:Langchain 简单实践 | moshiqiqian
langSmith配置步骤
建议先看文章:https://www.moshiqiqian.top/post/a2992615.html
补充相关知识
第一步:注册并获取 API Key
-
访问 smith.langchain.com 注册账
-
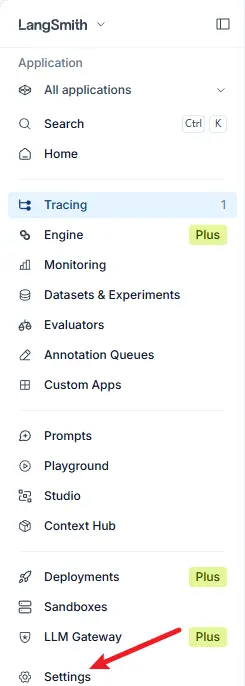
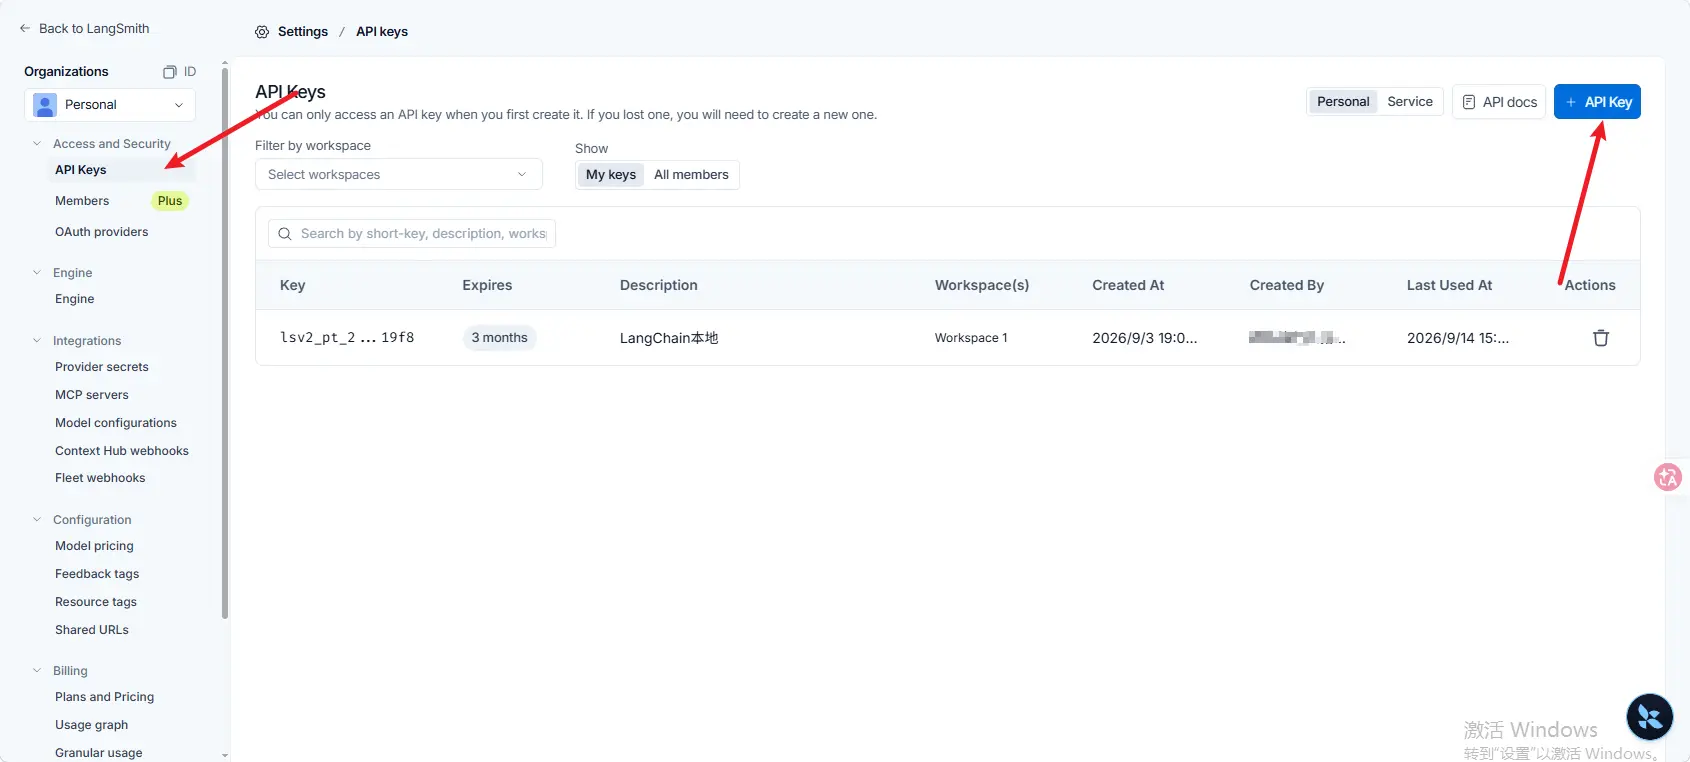
进入 Settings → API Keys 页面
-
点击 Create API Key,生成 Personal Access Token
-
复制生成的 Key(格式以
langchain_或lsv2_pt_开头)
注意:API Key 只在创建时显示一次,关掉页面就看不到了,务必立即保存。
第二步:找到 Workspace ID
Workspace ID 不在设置页面里,而是藏在浏览器地址栏的 URL 中。示例格式如下:

1 | https://smith.langchain.com/o/xxxxxxxx-xxxx-xxxx-xxxx-xxxxxxxxxxxx?tab=manage |
进入任意一个工作区后,看地址栏 /o/ 后面的那串 UUID 。
第三步:在本地写 .env 文件
在项目根目录创建 .env 文件,写入以下内容:
env
1 | # LangSmith 配置 |
关于 LANGSMITH_PROJECT:
- 这是你自己起的项目名字,在本地配置就行,可以自己设置。
- 不需要提前去云端创建,代码运行时会自动创建同名项目
实战
基础工作我们已经完成,接下来我们将由浅入深的体验LangChain的全流程
1_simple_llm_call.py
用一句话介绍这个任务:
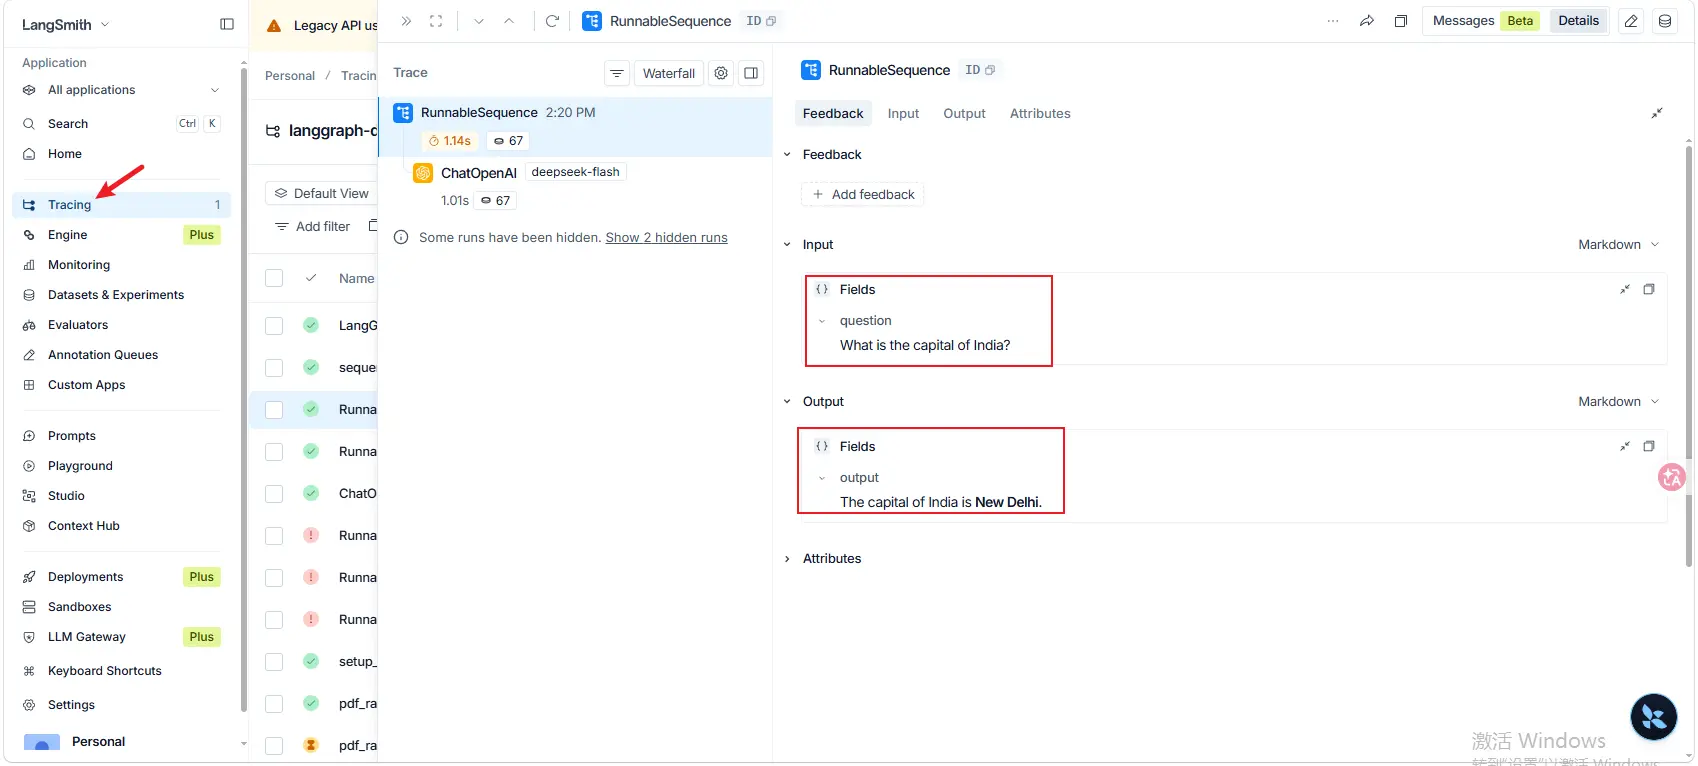
把一个问题包装成 Prompt,发给 DeepSeek,再把 DeepSeek 的返回解析成字符串,然后打印出来。
流程是:
text
1 | 问题 -> Prompt -> DeepSeek -> Parser -> 打印结果 |
这就是 LangChain 最基础的“链”。
在Langsmith里可以看到工作的流程
bash
1 | warnings.warn( |
它是 LangChain 的“Hello World”,最小可运行的链,这意味着你正式进入Langchain的大门。
2_sequential_chain.py
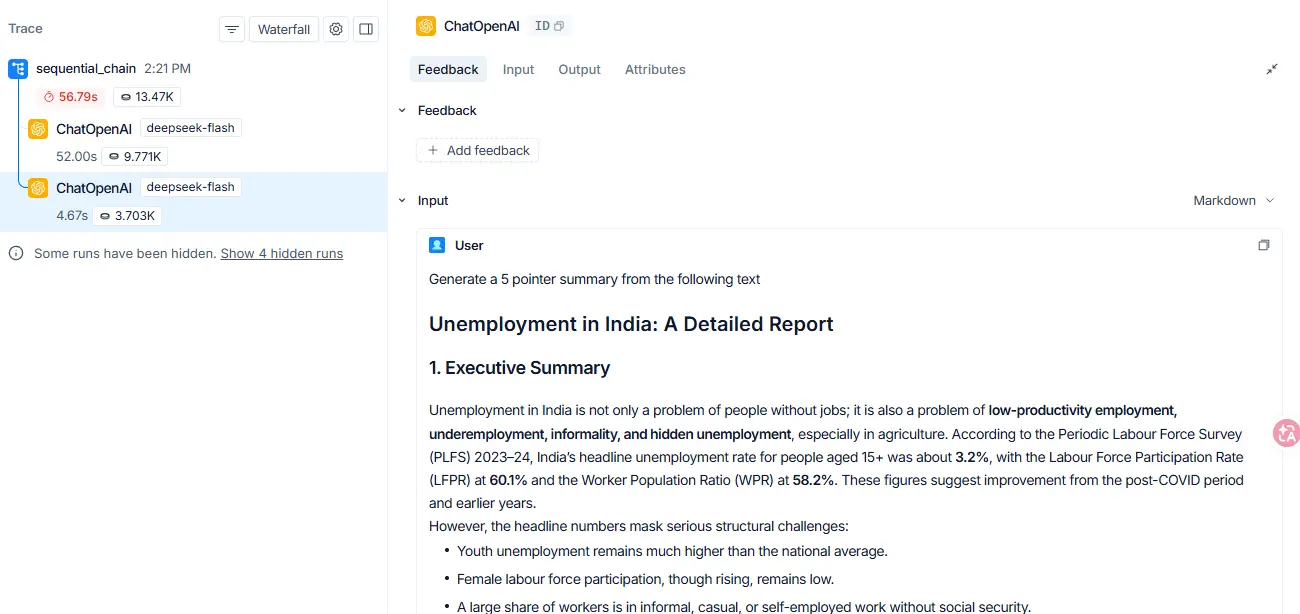
本文件的流程是:
text
1 | 主题 |
所以你按回车一次,背后其实是两次模型调用。
LangSmith流程
bash
1 | warnings.warn( |
3_rag_v1、2、3、4.py
四个脚本用的是同一个 PDF、同一条 RAG 流程,区别只有三点:
| 脚本 | 缓存 | 根节点 | trace 细分 | 每次运行速度 |
|---|---|---|---|---|
| 3_rag_v1.py | × | × | × | 几分钟 |
| 3_rag_v2.py | × | × | √ | 几分钟 |
| 3_rag_v3.py | × | √ | √ | 几分钟 |
| 3_rag_v4.py | √ | √ | √ | 命中几秒,未命中几分钟 |
逐条说:
-
v1:最基础。加载 PDF → 切块 → 生成向量 → 建索引 → 检索 → 生成回答。没有缓存,没有根节点,LangSmith 里只能看到 retriever -> prompt -> LLM -> parser。
-
v2:流程和 v1 一样,但把 load_pdf、split_documents、build_vectorstore、setup_pipeline 各自包装成独立的 span,LangSmith 里能看清每一步的耗时和数据。
-
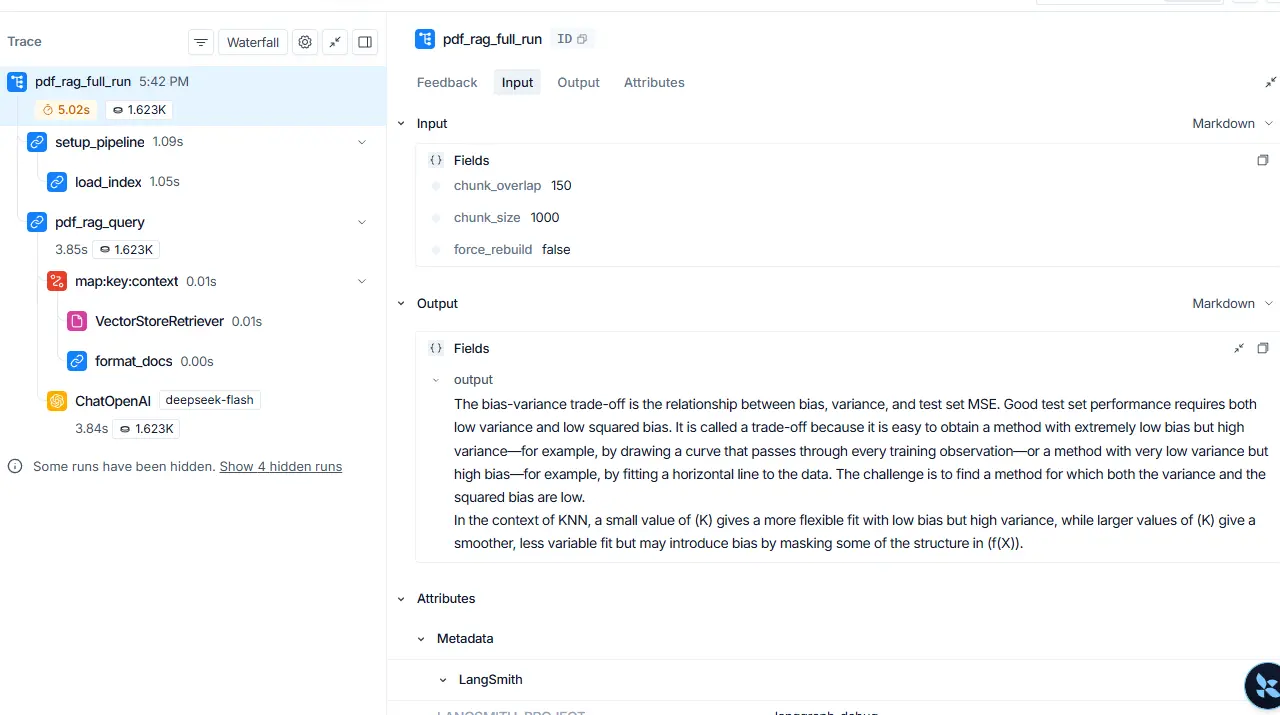
v3:在 v2 基础上,加了一个根节点 pdf_rag_full_run,把“初始化索引”和“查询”都归到同一棵树下面。
-
v4:在 v3 基础上,加了索引缓存。命中缓存时只做 load_index,跳过重建;参数变化时缓存失效,才会走 load_pdf -> split_documents -> build_vectorstore。
-
3_rag_v1.py
目标:先跑通最基础的 RAG。
流程:
text
1 | 问题 |
特点:
-
没有缓存,每次运行都要重新加载 PDF、切块、生成向量、建索引
-
第一次运行会慢(几分钟)
-
LangSmith 里只看到
retriever -> prompt -> LLM -> parser -
看不到
load_pdf、split_documents、build_vectorstore的细分 -
3_rag_v2.py
目标:把 RAG 每个阶段在 LangSmith 里分开显示。
流程和 v1 完全一样:
text
1 | 问题 -> load_pdf -> split_documents -> build_vectorstore |
区别只有一点:
-
v2 给每个阶段都加上了独立的 trace
-
在 LangSmith 里你能看到:
load_pdfsplit_documentsbuild_vectorstoreretrieverpromptLLMparser
-
3_rag_v3.py
目标:把一次 RAG 请求组织成一棵完整的 trace 树。
流程和 v2 一样,区别在 LangSmith 结构:
text
1 | pdf_rag_full_run ← 根节点 |
对比 v2:
- v2 是散落的多个顶层 run
- v3 是一个根节点
pdf_rag_full_run,所有子节点都挂在它下面
- 3_rag_v4.py
目标:加缓存,让 RAG 跑得更快。
流程和前面一样,但多了一步:先查缓存。
它会根据下面这些东西算一个缓存键:
- PDF 内容
chunk_sizechunk_overlap- 嵌入模型名
然后去 .indices 目录里找有没有匹配的索引。
情况 1:缓存命中
text
1 | setup_pipeline -> load_index |
跳过加载 PDF、切块、生成向量、建索引。
速度从几分钟变成几秒。
情况 2:缓存未命中
text
1 | load_pdf -> split_documents -> build_vectorstore |
这时它就和 v1 一样慢。
4_agent.py
目标:让模型自己决定要不要调工具、调哪个工具、调几次。
这是整条学习路线里第一次出现 Agent。
前面几个脚本的流程都是固定的:
text
1 | Prompt -> LLM -> Parser |
但 Agent 不一样,它的流程是动态的:
- 模型先“想”该做什么
- 然后“行动”,调用工具
- 看工具返回结果
- 再继续“想”
- 直到能给出最终答案
用一句话说:
模型在推理和行动之间循环,直到拿到答案。
ReAct 循环
Agent 的核心就是 ReAct:
ReAct = Reasoning + Acting,也就是“推理 + 行动”。
流程是:
text
text
1 | 用户问题 |
这个循环会一直重复,直到模型认为可以给出最终答案。
两个工具
4_agent.py 里配了两个工具:
| 工具 | 作用 |
|---|---|
duckduckgo_search |
联网搜索 |
get_weather_data |
查询城市当前温度 |
duckduckgo_search
用 ddgs 包调 DuckDuckGo:
python
python
1 | @tool |
每次搜索取前 10 条结果,只返回第一条的摘要。
get_weather_data
天气工具有两套实现,会自动选择:
- 如果
.env里配了OPENWEATHERMAP_API_KEY→ 用 OpenWeatherMap - 如果没有配 → 自动降级到 Open-Meteo(免费,无需 Key)
所以即使没有天气 Key,4_agent.py 依然能查天气。
Open-Meteo 返回的是数字天气代码,脚本里用 WMO_WEATHER_CODES 把它翻译成中文,比如:
text
text
1 | 0 -> 晴 |
ReAct 提示词
Agent 需要一个提示词,告诉它:
- 先想什么
- 怎么调工具
- 用什么格式输出
脚本从 LangSmith Hub 拉取官方 ReAct 提示词:
python
python
1 | base_prompt = Client().pull_prompt( |
然后追加一句中文说明:
python
python
1 | prompt = PromptTemplate.from_template( |
注意:
Thought、Action、Action Input、Final Answer这些协议关键字不能改,否则 Agent 就不知道怎么解析自己的输出了。
创建 Agent
python
1 | agent = create_react_agent( |
verbose=True:终端里打印Thought、Action、Observationmax_iterations=5:最多循环 5 次,防止无限循环
运行
默认任务是:
请先搜索卡尔帕娜·乔拉的出生城市,再查询该城市当前的温度。
python
python
1 | response = agent_executor.invoke({ |
终端里会看到什么
运行时终端会依次打印:
text
text
1 | > Entering new AgentExecutor chain... |
重点观察:
Thought:模型在想什么Action:模型决定调哪个工具Action Input:传给工具的参数Observation:工具返回的结果Final Answer:最终答案
LangSmith 里能看到什么
在 LangSmith 的 langgraph-debug 项目里,这次运行会显示:
- 一个 Agent 根 run
- 两次工具调用各自成为独立的 span:
duckduckgo_searchget_weather_data
- 每次工具调用的输入和输出
- 每一次
Thought、Action、Observation
重点看:
- 工具调用的顺序
- 搜索返回的城市名,如何被当成天气查询的输入
- 循环了几次
- 每次工具调用耗时多少
5_langgraph.py
目标:用 LangGraph 编排一次多节点、并行的结构化评分。
这是整条学习路线的最后一个脚本,也是唯一真正使用 LangGraph 的脚本。
前面几个脚本的流程都是线性的:
text
1 | A -> B -> C |
但 LangGraph 不一样,它把流程组织成一张图:
- 节点是函数
- 节点之间用边连接
- 可以并行,可以分支,可以汇合
- 所有节点共享一个 State
用一句话说:
LangGraph 让你把多个节点组织成一张图,并且能控制并行、依赖和状态合并。
整体流程
text
text
1 | START |
三个评分节点并行执行,各自调用一次模型。
汇总节点再调用一次模型,把三份反馈合并成最终评价。
一共 4 次模型调用:
- 三个评分节点各一次
- 汇总节点一次
State
LangGraph 里的节点共享一个 State:
python
python
1 | class UPSCState(TypedDict, total=False): |
重点在:
python
python
1 | individual_scores: Annotated[List[int], operator.add] |
这叫 reducer。
意思是:
- 每个评分节点都往
individual_scores里写一个分数 - 三个节点并行跑
- LangGraph 用
operator.add把它们合并成一个列表
如果没有 reducer,三个节点会互相覆盖,最后只能看到一个分数。
结构化输出
每个评分节点都要求模型返回固定 schema 的 JSON:
python
python
1 | class EvaluationSchema(BaseModel): |
这样每个节点的返回都是:
json
json
1 | { |
在 Prompt 里也必须出现 “JSON” 字样:
python
python
1 | prompt = ( |
否则 DeepSeek 会报:
text
text
1 | Prompt must contain the word 'json' in some form to use 'response_format' of type 'json_object'. |
三个评分节点
三个节点的结构几乎一样,只是评的维度不同:
| 节点 | 评分维度 |
|---|---|
evaluate_language |
语言质量 |
evaluate_analysis |
分析深度 |
evaluate_thought |
思想清晰度 |
每个节点都:
- 拼一段 Prompt
- 调
structured_model - 返回
{xxx_feedback, individual_scores: [score]}
另外它们都加了 @traceable:
python
python
1 | @traceable(name="evaluate_language_fn", tags=["维度:语言"], metadata={"dimension": "语言"}) |
这样在 LangSmith 里能单独看到每个节点的 trace、tag 和 metadata。
汇总节点
python
python
1 | @traceable(name="final_evaluation_fn", tags=["汇总"]) |
它做两件事:
- 读取三个维度的反馈,调模型生成整体评价
- 读取
individual_scores,算平均分
注意:individual_scores 在这时已经被 reducer 合并成了完整列表。
构建图
python
python
1 | graph = StateGraph(UPSCState) |
这就是:
- fan-out:从 START 分出三条边,三个评分节点并行
- fan-in:三条边都指向
final_evaluation,汇总节点等待它们完成
运行
python
python
1 | result = workflow.invoke( |
config 会一起上传到 LangSmith,所以你能在 trace 里看到:
- run name:
evaluate_upsc_essay - tags:
文章评估、langgraph、自动评分 - metadata:
essay_lengthmodeldimensions
终端里会看到什么
text
text
1 | === 评估结果 === |
[3, 4, 7] 就是三个评分节点各自给出的分数。
平均分:
text
text
1 | (3 + 4 + 7) / 3 = 4.666... |
LangSmith 里能看到什么
在 LangSmith 的 langgraph-debug 项目里,这次运行会显示:
- 一个根 run:
evaluate_upsc_essay - 三个评分节点并行
- 三条边从 START 分出去
- 三条边汇合到
final_evaluation individual_scores从空列表变成[3, 4, 7]- 每个节点都有自己的 tag 和 metadata
重点看:
- fan-out:START 分出三个分支
- fan-in:三个分支汇合到
final_evaluation - State 变化:
individual_scores被 reducer 合并 - 结构化输出:每个评分节点返回
{feedback, score} - tags 和 metadata:是否正确显示
你可以做的实验
把 5_langgraph.py 里的 essay2 换成你自己的英文短文,再运行一次,对比分数。
你会看到:
- 三个维度分数变化
- 平均分变化
- 综合反馈变化
这能让你更直观地理解:
不同输入 → 不同分数 → 不同汇总评价
这一节的教学点
| 学会什么 | 说明 |
|---|---|
| 什么是 LangGraph | 用图的方式编排 LLM 工作流 |
| 什么是并行 | 多个节点同时跑 |
| 什么是 fan-out / fan-in | 分出去、汇合 |
| 什么是 State + reducer | 多个节点共享状态并合并 |
| 什么是结构化输出 | 让模型返回固定 schema 的结果 |
| 怎么在 LangSmith 看并行 | 看到三个分支和一次汇合 |
一句话总结
5_langgraph.py用 LangGraph 编排一次多节点并行评分:
- 三个评分节点并行执行
- 分数通过 reducer 合并成
[3, 4, 7]- 汇总节点给出整体反馈和平均分
- LangSmith 里能看到 fan-out、fan-in、State 变化和结构化输出
 微信
- 支付宝